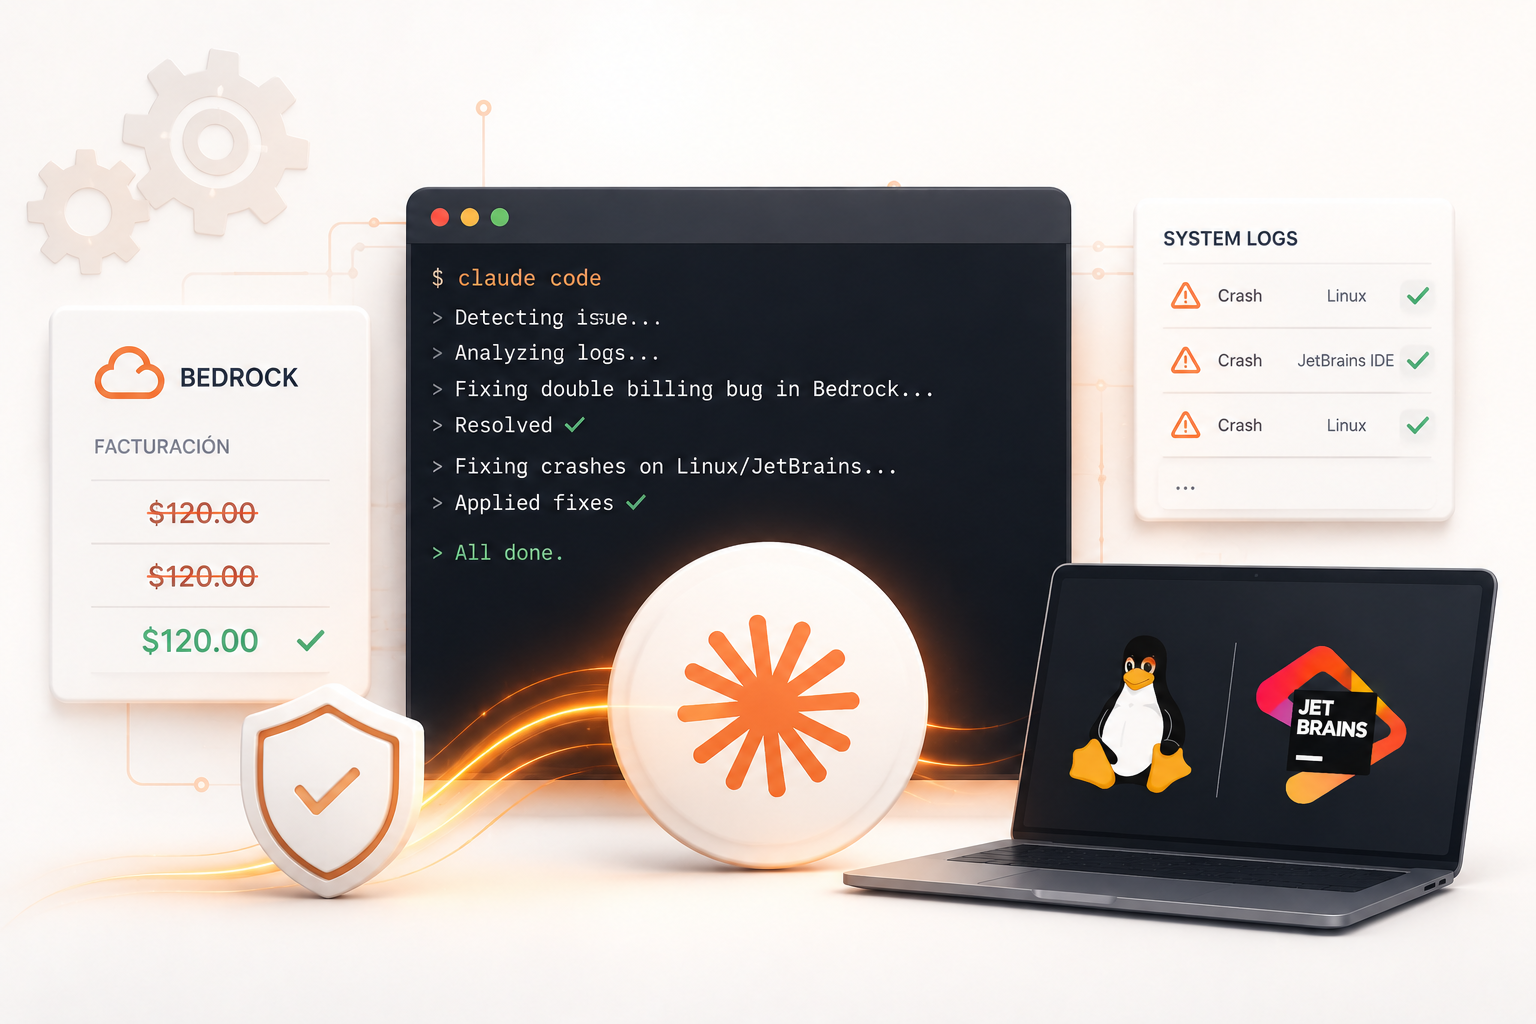
El último release de Claude Code trae un arreglo que conviene mirar con la calculadora delante: un fallo en el streaming de Bedrock detrás de proxies duplicaba de forma silenciosa el coste de cada turno. No había mensaje de error, no había advertencia y el CLI funcionaba con aparente normalidad. Simplemente, cada intercambio se pagaba dos veces. La misma versión corrige además un cuelgue al iniciar sesión con SSO a través de proxy HTTPS, una pausa de unos cinco segundos en cada Edit o Write dentro de JetBrains y varios problemas de soporte en Alpine y musl.
El detalle importante no es el bug en sí, sino quién lo ha estado pagando sin enterarse: casi por definición, el perfil afectado es el de equipos que acceden a los modelos de Claude a través de Amazon Bedrock desde una red corporativa o una VPN, es decir, justo el tipo de despliegue donde nadie revisa el consumo a diario porque la factura la mira otro departamento a fin de mes.
Por qué un proxy corporativo termina en una factura doble
Para entender el problema hay que recordar cómo habla Claude Code con el modelo. En condiciones normales la respuesta llega en streaming: una conexión que se mantiene abierta y por la que van cayendo fragmentos de texto conforme se generan. Es lo que hace que veas la respuesta aparecer poco a poco en lugar de esperar en blanco a que termine.
Los proxies corporativos y las inspecciones TLS intermedias se llevan históricamente mal con ese tipo de conexión. Muchos almacenan la respuesta entera antes de reenviarla, o directamente cortan las conexiones que permanecen abiertas más de lo que su configuración considera razonable. Cuando eso ocurre contra Bedrock, el cliente se encuentra con una conexión que no se comporta como debería y recurre al plan B: reintentar la misma petición en modo no-streaming.
Ahí está el agujero. Ese plan B es correcto desde el punto de vista de la usabilidad — el usuario recibe su respuesta y no ve nada raro — pero el primer intento ya había consumido tokens. Se factura el trabajo del modelo, no lo que llega a tu terminal. El resultado es un turno cobrado dos veces, repetido en cada intercambio de cada sesión, durante todo el tiempo que ese proxy haya estado en medio.
Se factura el trabajo del modelo, no lo que llega a tu terminal.
Lo que convierte esto en algo más serio que un bug corriente es la ausencia de señal. Un error de red se ve: la petición falla, el CLI lo dice, alguien lo investiga. Un sobrecoste del 100% en un entorno donde el gasto de tokens ya es variable de por sí no se ve, porque no hay una línea base contra la que compararlo. Si tu consumo sube un mes, la explicación por defecto siempre es que se ha trabajado más.
Cómo saber si te ha tocado
No hace falta un análisis forense para salir de dudas. El fallo tiene tres condiciones que deben darse a la vez, y basta con que falte una para descartarlo:
- Usas Bedrock como proveedor, no la API directa de Anthropic. Si tu configuración apunta a la API de Anthropic sin más, esto no te afecta.
- Hay un proxy o inspección TLS por medio: red corporativa, VPN obligatoria, un
HTTPS_PROXYexportado en tu entorno o una salida a internet filtrada. - Las sesiones son largas. El coste se duplica por turno, así que el impacto crece con el número de intercambios, no con el tamaño del proyecto.
Si las tres se cumplen, el sitio donde mirar es el desglose de consumo de Bedrock por día. Lo que buscas no es una cifra alta, sino un escalón: un punto en el que el consumo por sesión se dispara sin que haya cambiado tu forma de trabajar, y que se mantiene estable a partir de ahí. Ese perfil — salto brusco y meseta posterior — es el que delata un problema de configuración y no un aumento de actividad.
⚠️ Si gestionas el gasto de un cliente
Revisa la facturación de las últimas semanas antes de que se cierre el periodo. Si el consumo estaba inflado, es información que el cliente merece conocer por tu parte y no descubrir por su cuenta más adelante. Documenta la fecha del arreglo y el consumo posterior: la comparación entre ambos periodos es la prueba más limpia de que el sobrecoste era técnico.
El resto del release también apunta al mismo sitio
Los demás arreglos de esta versión comparten un patrón que dice bastante sobre dónde está creciendo Claude Code. El cuelgue al iniciar sesión con SSO detrás de un proxy HTTPS es, otra vez, el mismo escenario: la red corporativa. La pausa de unos cinco segundos en cada operación de Edit o Write dentro de JetBrains golpeaba a quien trabaja en IntelliJ, PyCharm o PhpStorm, entornos con presencia muy fuerte en desarrollo empresarial. Y las mejoras en Alpine y musl — pegado, portapapeles y captura de audio — afectan a contenedores ligeros, que es donde acaban ejecutándose los agentes cuando alguien los mete en un pipeline.
A eso se suma un arreglo puntual pero molesto que llegó un día antes: el crash de arranque en Linux con glibc 2.44, que dejaba fuera de juego a quien trabaja sobre Arch, CachyOS o Fedora Rawhide. Es un problema típico de distribuciones rolling release y, por extensión, de bastantes entornos WSL usados como máquina de trabajo real.
Ninguno de estos cuatro fallos es espectacular por separado. Juntos dibujan una herramienta que ha dejado de vivir en el portátil de un desarrollador suelto y está entrando en sitios con proxies, SSO, IDEs corporativos y contenedores de CI. Ese salto de contexto es precisamente el que hace aparecer bugs que no se ven en un entorno doméstico, y el de Bedrock es el ejemplo perfecto: para reproducirlo hacía falta una combinación que ningún desarrollador tiene en su máquina de casa.
Fijar la versión antes de escalar el pipeline
La conclusión práctica va más allá de actualizar y seguir. Si Claude Code se dispara desde algún sitio automatizado — un nodo de n8n, un cron, un job de CI, un script de despliegue — este release deja dos deberes concretos.
El primero es fijar la versión en lugar de tirar siempre de la última disponible. Un agente que se actualiza solo dentro de un pipeline es cómodo hasta el día en que un cambio de comportamiento se propaga a producción sin que nadie lo haya probado. Fijar versión, probar el fix en un entorno de staging y promover después es la diferencia entre un incidente y un martes normal.
El segundo es montar una alerta de consumo, aunque sea rudimentaria. Un umbral diario de gasto que dispare un aviso es media hora de trabajo y habría reducido este bug de semanas a un par de días. La lección que deja el fallo no es que Bedrock falle detrás de un proxy: es que los costes de un agente son un dato que hay que vigilar activamente, porque su variabilidad natural esconde muy bien cualquier anomalía.
Actualizar cuesta un minuto y no tiene contraindicaciones conocidas. Lo que puede costar más caro es no mirar hacia atrás: si el escenario descrito coincide con tu configuración, la revisión de la facturación de las últimas semanas es más urgente que la propia actualización.