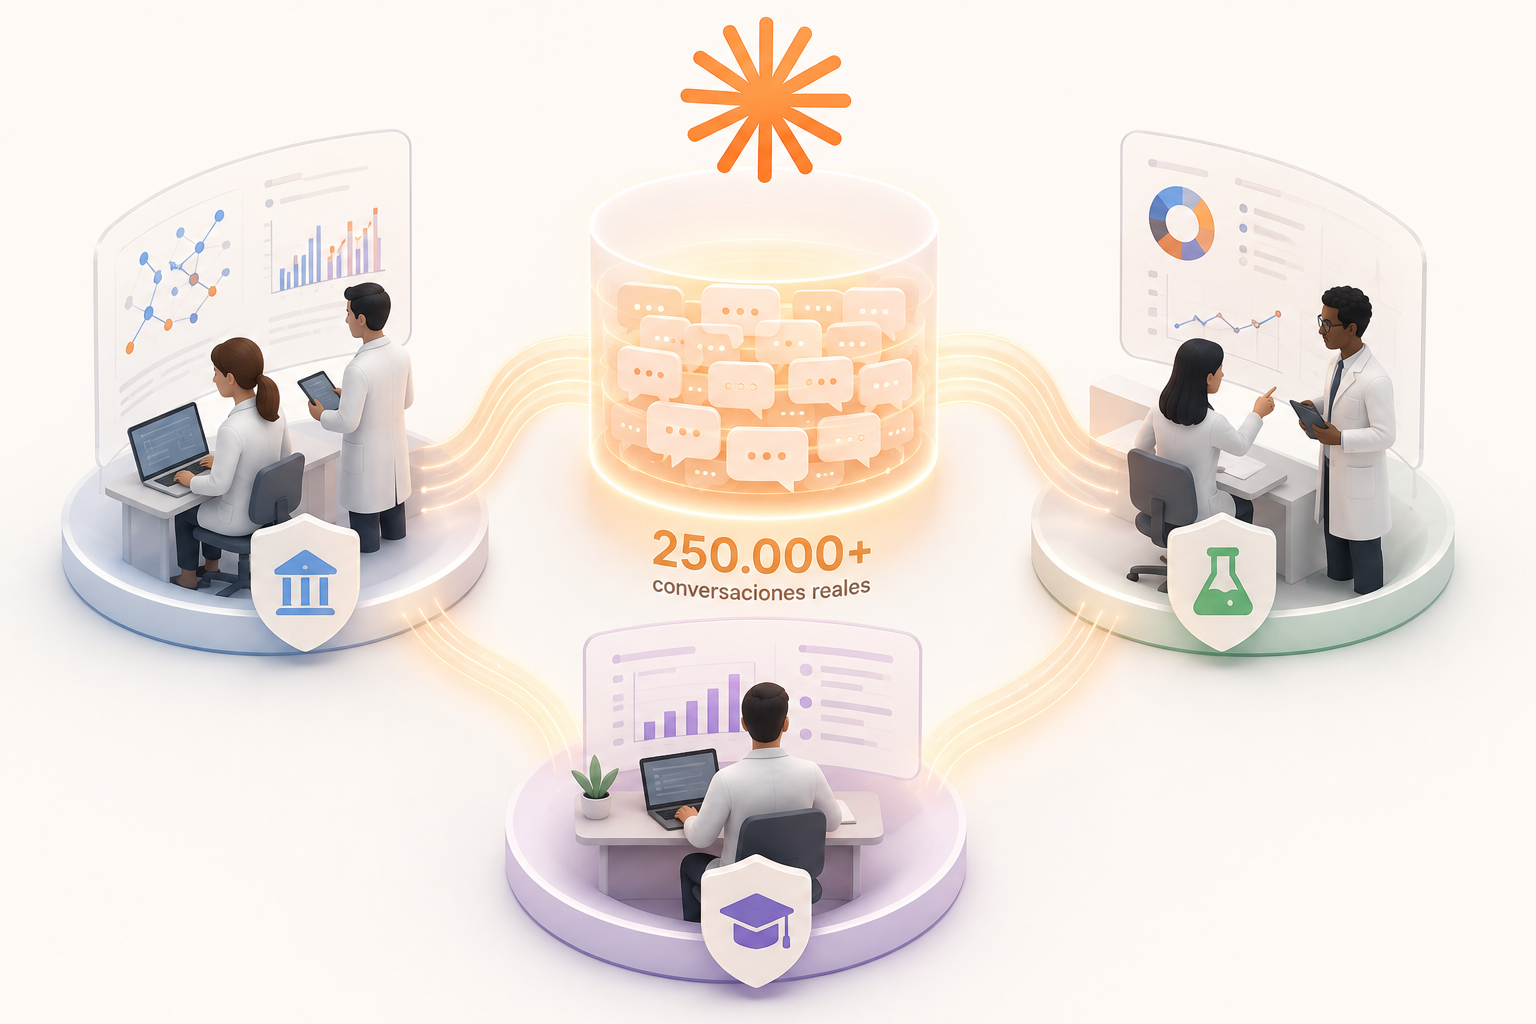
Anthropic ha dado un paso poco habitual en la industria: ha permitido que tres grupos de investigación externos analicen alrededor de 250.000 conversaciones reales de Claude.ai y Claude Code. El acceso no se hizo entregando transcripciones, sino a través de un sistema de análisis diseñado para preservar la privacidad, de modo que los equipos pudieran estudiar patrones agregados sin leer conversaciones individuales.
Es un movimiento que interesa por partida doble. Por un lado, ataca uno de los problemas estructurales del campo: casi todo lo que sabemos sobre cómo se usan estos sistemas procede de quien los vende. Por otro, plantea preguntas legítimas para cualquiera que use Claude en trabajo con datos ajenos.
Estudiar una tecnología cuyos datos son propiedad privada
La investigación académica sobre modelos de lenguaje arrastra una limitación difícil de superar: los datos de uso real están dentro de las empresas y no salen. Los estudios independientes se han hecho, casi sin excepción, con lo único disponible desde fuera: encuestas a usuarios, benchmarks sintéticos, pruebas de laboratorio y análisis de lo que la gente publica voluntariamente.
Ninguna de esas vías captura el uso cotidiano. Una encuesta recoge lo que la gente recuerda y está dispuesta a contar. Un benchmark mide una tarea diseñada para ser medida. Y lo que se publica en foros está fuertemente sesgado hacia los extremos: el resultado espectacular y el fallo indignante. El uso normal — el 90% del volumen — es justo lo que nunca se ve, porque no tiene nada de interesante que contar.
Esa opacidad tiene consecuencias que van más allá de lo académico. Las decisiones regulatorias, las políticas de empresa y hasta el debate público sobre el impacto laboral de estas herramientas se apoyan en estimaciones construidas sin acceso a lo que la gente hace de verdad con ellas. Abrir una ventana de 250.000 conversaciones no resuelve el problema, pero cambia la naturaleza de la discusión: de opiniones sobre el uso a datos sobre el uso.
Casi todo lo que creemos saber sobre cómo se usa la IA procede de quien la vende.
Analizar sin leer: qué implica ese diseño
La parte técnicamente relevante del anuncio es el mecanismo. Los investigadores no recibieron un volcado de conversaciones: trabajaron a través de un sistema de análisis que preserva la privacidad, orientado a extraer patrones agregados en lugar de permitir la lectura directa de casos concretos.
Ese enfoque impone un intercambio que conviene entender. Lo que se gana es evidente: un investigador puede responder preguntas del tipo qué proporción de las sesiones de Claude Code corresponde a depuración frente a escritura de código nuevo sin que ninguna persona ajena vea el código de nadie. Lo que se pierde es la posibilidad de inspeccionar el caso raro, que en investigación de seguridad suele ser el más informativo. Un sistema pensado para agregar es, por construcción, malo para encontrar excepciones.
Queda además una limitación que ningún diseño técnico resuelve: el acceso lo concede la empresa estudiada. Anthropic decide qué grupos entran, sobre qué conjunto y con qué herramientas. Eso no invalida los resultados — la alternativa realista no es un acceso mejor, es ninguno — pero sí marca la diferencia entre esto y una auditoría independiente en sentido estricto. Es un avance sustancial dentro de un modelo que sigue siendo de acceso concedido.
Que Claude Code esté dentro del conjunto no es un detalle
La mayoría de coberturas se han quedado con la cifra, pero el dato que más dice sobre el futuro de estos estudios es la composición: no son solo conversaciones de chat, sino también sesiones de Claude Code. Y una sesión de trabajo con un agente sobre un repositorio es un objeto muy distinto de una conversación.
En el chat, el modelo responde. En Claude Code, ejecuta: lee ficheros, corre comandos, modifica el proyecto. Eso convierte cada sesión en un registro de comportamiento, no de opinión, y abre preguntas que hasta ahora solo se podían responder por intuición. Cuántas veces se acepta una propuesta del agente sin revisarla. Qué tipos de tarea se le delegan por completo y cuáles se le quitan a la mitad. Cuánto del trabajo real es escribir código nuevo y cuánto es entender código que ya existe.
Son exactamente las preguntas cuyas respuestas hoy circulan en forma de anécdota, y son también las que determinan si el discurso sobre la productividad de estas herramientas se sostiene con números. Si de estos tres estudios sale una descripción fiable del reparto real entre depuración, refactor y código nuevo, será la primera vez que exista.
⚠️ Si trabajas con repositorios de cliente
Este anuncio es un buen momento para releer qué política de retención y de uso de datos aplica a tu plan concreto, que no es la misma en todos. Si tienes acuerdos de confidencialidad firmados con clientes, la pregunta relevante no es si Anthropic protege bien los datos, sino qué te comprometiste tú a no enviar fuera. Esa revisión te corresponde a ti y no depende de las garantías técnicas del proveedor.
La transparencia también tiene una lectura estratégica
Sería ingenuo leer el anuncio solo en clave de generosidad científica. Abrir datos a investigadores independientes es, para una empresa de IA en 2026, una posición ventajosa ante un entorno regulatorio que se está escribiendo ahora mismo. Llegar a esa conversación con estudios externos publicados es muy distinto de llegar con informes propios.
Eso no resta valor a la iniciativa. Que los incentivos estén alineados con algo bueno es precisamente lo que hace que ese algo se repita, y aquí el incentivo empuja en la dirección correcta: si el acceso a datos reales se convierte en un factor de reputación entre proveedores, la presión competitiva hará el resto. La pregunta que quedará por responder dentro de unos meses es si los resultados se publican también cuando resultan incómodos para quien concedió el acceso.
Para quien usa estas herramientas a diario, la conclusión práctica es más modesta pero útil: por primera vez habrá cifras externas sobre cómo se trabaja realmente con un agente de código. Merece la pena estar atento a esos estudios cuando salgan, porque van a ser la mejor referencia disponible para contrastar la propia experiencia — y para responder, con algo más que una impresión, a la pregunta de cuánto tiempo ahorra esto de verdad.