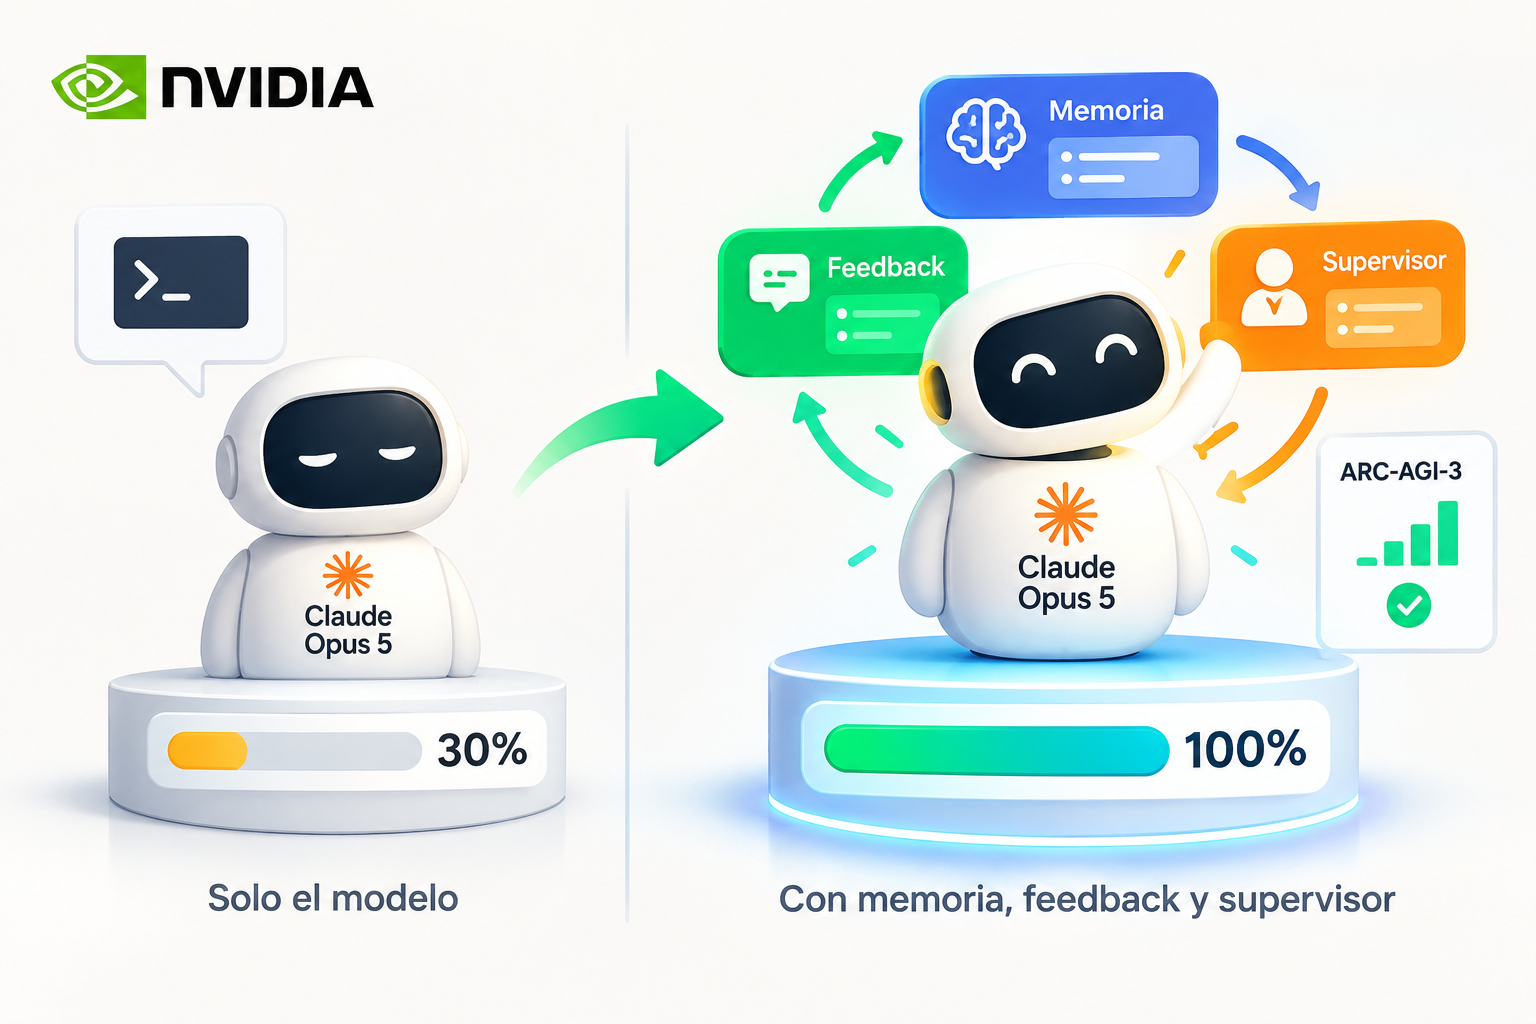
Llevo meses leyendo comparativas de modelos con la sensación incómoda de estar mirando al sitio equivocado, y esta semana un grupo de investigadores de Nvidia le ha puesto número a esa sospecha. El mismo Claude Opus 5 que se queda en un 30% en ARC-AGI-3 alcanza el 100% cuando lo envuelven en un sistema con memoria, feedback y un supervisor que corrige sus pasos. Setenta puntos de diferencia sin cambiar de modelo, sin esperar a la siguiente versión, sin pagar un céntimo más por token. Mi postura, que sé que va a contracorriente de un feed obsesionado con benchmarks: para un freelance que vive de entregar, elegir modelo es de las decisiones menos importantes que va a tomar este año.
Un 30% y un 100% salen exactamente del mismo modelo
Conviene detenerse en lo que significa ese dato antes de seguir, porque es fácil leerlo como una anécdota de laboratorio. ARC-AGI-3 es un banco de pruebas diseñado precisamente para resistirse a la memorización: mide si un sistema puede resolver problemas cuya forma no ha visto antes. Que Opus 5 lo resuelva al 30% en solitario y al 100% dentro de un andamiaje no dice que el modelo sea mejor o peor de lo que pensábamos. Dice algo bastante más interesante: la capacidad ya estaba dentro, y lo que faltaba era la estructura para sacarla.
Los tres ingredientes que añadieron no son exóticos. Memoria, para que el sistema no vuelva a empezar de cero en cada intento. Feedback, para que sepa si lo que acaba de hacer funcionó. Y un supervisor, algo que mire el resultado y decida si hay que repetir. Cualquiera que haya montado una automatización medianamente seria reconoce ese esquema, porque es el mismo que llevamos años aplicando a procesos que no tenían nada que ver con la IA: guardar estado, comprobar resultado, reintentar. Lo que ha cambiado es que ahora ese esquema aplicado a un modelo de lenguaje multiplica su rendimiento en lugar de simplemente hacerlo más robusto.
Setenta puntos de diferencia no salieron de un modelo mejor. Salieron de un sistema mejor alrededor del mismo modelo.
Llevo dos años construyendo harness sin saber que se llamaba así
Aquí es donde esto deja de ser noticia de portada tecnológica y se vuelve personal. Cuando escribo un CLAUDE.md que acumula el criterio de un proyecto —cómo se nombran los archivos, qué no se toca nunca, qué formato tiene la salida— estoy construyendo memoria. Cuando monto un flujo en n8n que reintenta una llamada fallida y me avisa si el resultado no cumple una condición, estoy construyendo feedback. Y cuando lanzo un subagente para que revise lo que escribió otro antes de que llegue a mí, estoy construyendo un supervisor. Es literalmente el mismo esquema, montado a mano y por intuición, sin haberle puesto nombre.
Lo digo sin ninguna vanidad, porque el reverso es más incómodo: si eso es lo que de verdad mueve la aguja, entonces todas las horas que he dedicado a comparar salidas de un modelo contra otro han sido, en gran parte, tiempo mal invertido. Y no hablo de un par de tardes. Hablo del reflejo automático de abrir la comparativa cada vez que sale una versión nueva, de rehacer pruebas que ya había hecho, de la conversación recurrente con otros freelances sobre cuál rinde mejor para tal cosa. Todo ese esfuerzo compite por el mismo tiempo que podría ir a documentar mejor un proyecto o a montar el paso de verificación que llevo tres meses posponiendo.
Hay además una asimetría que me parece decisiva y que casi nadie menciona. El modelo lo tiene todo el mundo. Cualquier competidor mío puede pagar el mismo plan y acceder al mismo Opus el mismo día que yo. Lo que no puede copiar es el contexto acumulado de un cliente concreto, el conjunto de reglas que ha ido puliendo un proyecto durante seis meses, o el flujo que sabe exactamente qué revisar antes de publicar en un WordPress ajeno. El modelo es un insumo de mercado; el harness es lo único que se parece a un activo propio.
Dónde sí decide el modelo, y por qué ese margen es estrecho
No quiero venderlo como si el modelo diera igual, porque sería falso y además se nota. Hay un suelo por debajo del cual ningún andamiaje salva nada: si el modelo no entiende el problema, la memoria solo sirve para recordar errores y el supervisor solo consigue que se repitan más veces. El propio experimento lo demuestra al revés de como suele leerse, porque partía de un 30%, no de un 3%. El harness amplifica capacidad existente; no la inventa.
Lo que sostengo es que ese suelo ya lo hemos cruzado para el trabajo que hago yo y que hace la mayoría de la gente que me lee. Maquetar, integrar, automatizar publicaciones, revisar código de un plugin, transformar datos entre sistemas: hace tiempo que la limitación no está en si el modelo es capaz, sino en si le he dado el contexto correcto y en si alguien comprueba lo que devolvió. La diferencia entre dos modelos punteros en esas tareas se mide en matices; la diferencia entre tener o no tener verificación se mide en si el cliente encuentra el fallo antes que tú.
Y hay un detalle de coste que refuerza el argumento. Un harness bien montado permite bajar de modelo en los pasos que no lo necesitan, porque la calidad ya no depende de que el modelo acierte a la primera, sino de que el sistema detecte cuándo no acertó. Quien tiene verificación puede permitirse el modelo barato; quien no la tiene está obligado a pagar el caro y a cruzar los dedos igualmente.
Las tres piezas que montaría esta semana antes que probar nada nuevo
Si el experimento de Nvidia sirve de guía, la traducción a un stack de freelance es bastante directa y no requiere infraestructura de laboratorio. La memoria es un archivo de contexto por proyecto que se actualiza cuando algo cambia, no cuando uno se acuerda: si el criterio vive solo en tu cabeza, el sistema empieza de cero cada mañana. El feedback es cualquier comprobación automática después de una acción —que el post se creó, que el JSON valida, que la respuesta trae los campos esperados— en lugar de asumir que fue bien porque no saltó un error. Y el supervisor es el paso más barato y el que más se salta todo el mundo: una segunda pasada, con instrucciones distintas a las de la primera, que solo busque lo que pudo salir mal.
🔍 Prueba de un minuto
Coge tu automatización más usada y respóndete tres preguntas: ¿guarda algo entre ejecuciones, o cada una empieza de cero? ¿Sabe si su último resultado fue correcto, o solo si no falló? ¿Hay algún paso que revise la salida antes de que llegue al cliente? Cada «no» es un punto donde estás dejando rendimiento sobre la mesa que no se arregla cambiando de modelo.
Ninguna de las tres piezas es glamurosa. No hay nada que anunciar en redes cuando terminas de escribir la regla número catorce de un archivo de contexto, y por eso el debate público sigue girando alrededor de qué modelo saca más puntos en qué prueba. Es más fácil de contar y se agota en un titular.
Lo que me preocupa de que este dato pase desapercibido
Mi temor no es que la industria ignore el hallazgo: los equipos grandes llevan tiempo en esto y de ahí salen precisamente resultados como el de Nvidia. Mi temor es el freelance que sigue midiendo su nivel por lo actualizado que está en modelos, y que dentro de un año seguirá teniendo el mismo flujo frágil de siempre ejecutándose sobre un modelo más nuevo. Esa persona va a competir con otra que quizá use un modelo peor, pero que lleva doce meses acumulando contexto, verificaciones y correcciones sobre sus proyectos. No hay versión nueva que compense esa ventaja, porque no se compra: se sedimenta.
Así que mi conclusión es deliberadamente aburrida y por eso me fío de ella. La próxima vez que salga un modelo, dedícale el rato justo de comprobar que no rompe nada de lo que ya tienes montado, y devuelve el resto de esa tarde al sistema que lo rodea. El salto del 30% al 100% no lo firmó un modelo mejor. Lo firmó alguien que se sentó a construir lo que había alrededor, que es exactamente el trabajo que nadie va a hacer por ti y el único que sigue siendo tuyo cuando cambien las versiones.