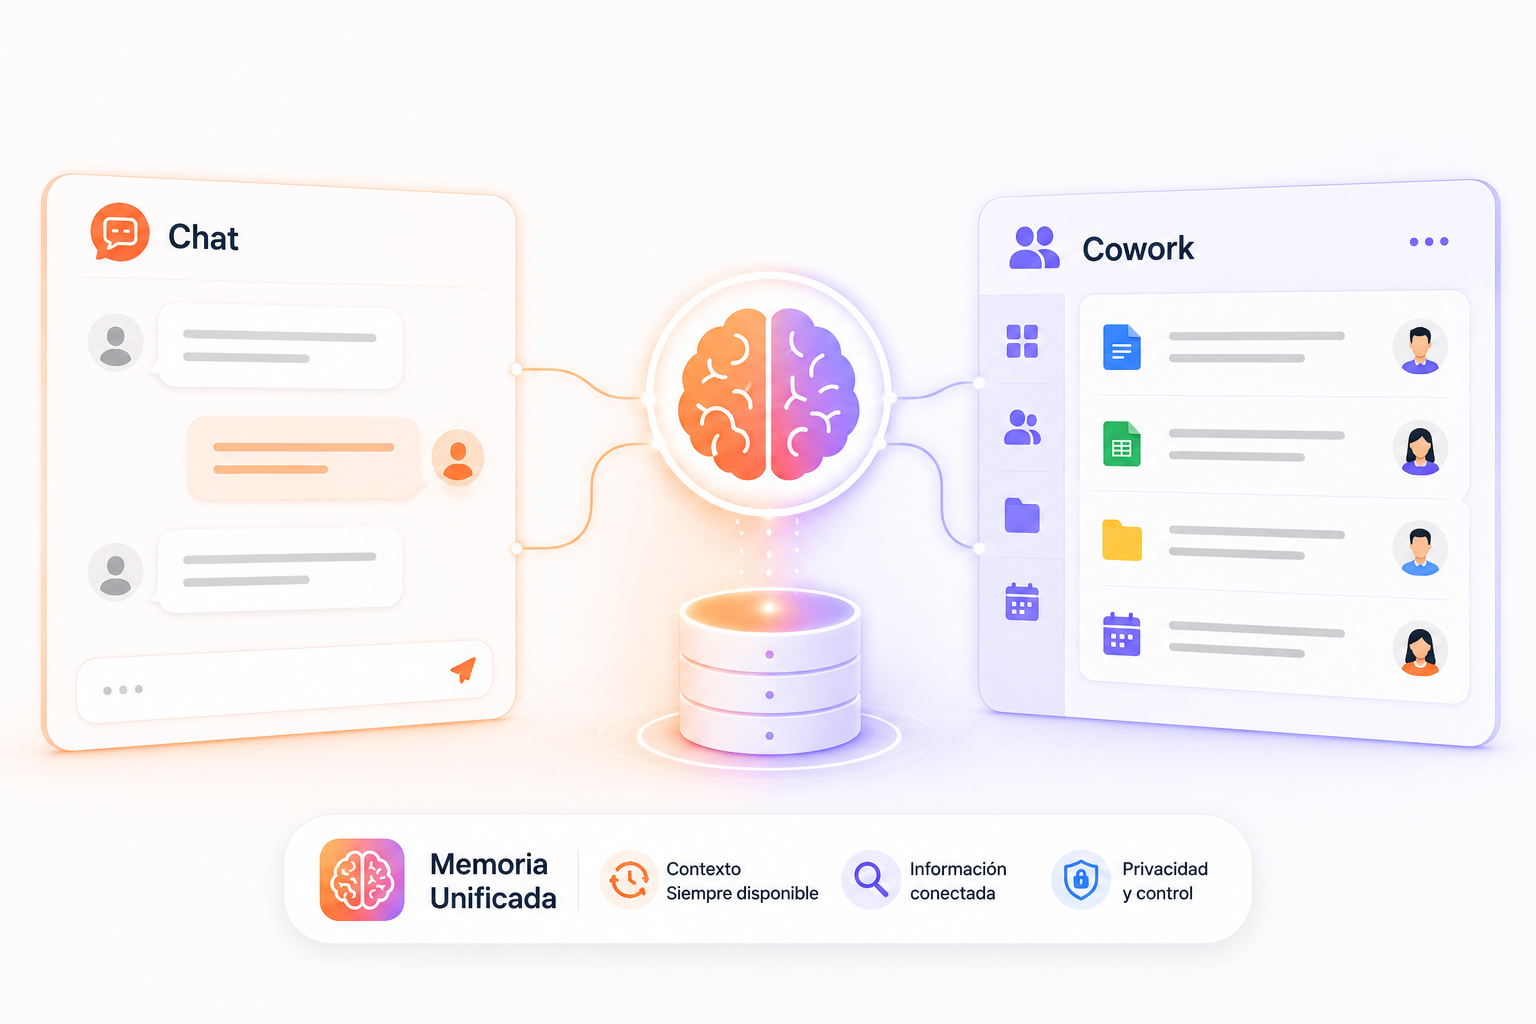
Anthropic ha unificado la memoria de Claude entre Chat y Cowork, y el titular que todo el mundo está escribiendo es que Claude por fin recuerda lo que le contaste. A mí esa parte me interesa la mitad. Lo que llevaba dos años esperando no es que recuerde: es poder abrir la lista de lo que ha guardado, leerla, corregir lo que está mal y borrar lo que no tiene por qué estar ahí. Eso es lo que ha cambiado hoy, y es lo único que hace que me plantee usar la memoria en trabajo de cliente.
Lo digo desde una postura concreta: soy freelance, trabajo a la vez con varios clientes, y el contexto que acumulo no es un lujo, es el activo. Una memoria persistente que no puedo inspeccionar no es una comodidad, es un pasivo con intereses. Durante meses la respuesta sensata fue no usarla. Con lo de hoy, esa respuesta cambia, pero no del todo.
Recordar era la parte fácil; el control es la noticia
Guardar contexto entre sesiones no es un problema técnico difícil. Cualquiera que haya montado un flujo con n8n y una base de datos vectorial sabe que persistir conversaciones es de primer día. Lo difícil, lo que las herramientas llevan evitando desde que existe el concepto de memoria en un asistente, es lo otro: enseñarle al usuario exactamente qué se ha quedado guardado y dejarle intervenir. Es incómodo de diseñar, es feo de mostrar y expone lo mucho que el sistema se equivoca al decidir qué merece recordarse.
Anthropic ha hecho además un cambio que se está contando como detalle menor y que para mí es el más relevante de todos: los temas se van añadiendo a medida que conversas, no en un resumen al final de la sesión. Quien haya sufrido resúmenes automáticos sabe por qué importa. Un resumen final es una interpretación de segunda mano: comprime, prioriza mal y se queda con el titular en lugar de con el matiz. Y el matiz es justo lo que necesitas seis semanas después, cuando vuelves a un proyecto y lo que hacía falta recordar no era que el cliente quería una tienda, sino que el cliente no quería variaciones de producto porque su ERP no las soporta.
Una memoria que no puedo auditar no es una comodidad: es un pasivo con intereses.
El puente entre Chat y Cowork es la consecuencia natural. Hasta ahora había una frontera absurda entre pensar y ejecutar: investigabas en un sitio, decidías el enfoque, y al pasar a la fase de ejecución tenías que reconstruir de memoria — la tuya, no la de la máquina — todo lo que ya habías razonado. Ese peaje se pagaba varias veces al día y nadie lo contabilizaba porque cada instancia costaba solo unos minutos. Sumados, son horas a la semana.
Un freelance no tiene un contexto: tiene doce clientes
Aquí es donde mi entusiasmo se enfría. Toda la narrativa de la memoria persistente está escrita pensando en una persona con un trabajo: un empleado, un proyecto, una empresa, un contexto que crece de forma coherente. Ese usuario gana sin matices. Yo no soy ese usuario, y sospecho que la mayoría de quien lea esto tampoco.
Cuando llevas cuatro proyectos de WordPress a la vez, el contexto de uno no debe tocar el del otro. No por manía: porque las decisiones técnicas de un cliente son información suya. Porque el presupuesto de uno no puede aparecer como referencia en una conversación sobre otro. Porque tres clientes del mismo sector no quieren compartir ni por accidente qué integración eligieron. Una memoria que aprende sola y cruza temas por su cuenta es exactamente el mecanismo por el que ese aislamiento se rompe sin que nadie lo note.
⚠️ Antes de activarla en trabajo de cliente
Revisa la lista de lo que Claude ha guardado y comprueba si hay datos que pertenecen a un proyecto y aparecen mencionados en el contexto de otro: nombres de cliente, cifras de presupuesto, credenciales de staging o decisiones de arquitectura. La separación por proyectos la impones tú, no la infiere la herramienta.
Que ahora pueda revisar y borrar convierte ese riesgo en algo gestionable, y por eso la noticia me parece buena. Pero gestionable significa que el trabajo de gestionarlo es mío. Hemos pasado de no lo uses a úsalo y audítalo cada cierto tiempo, que es mejor, pero es una tarea nueva en una lista que ya estaba llena.
Dónde esto sí me cambia la semana
Con las reservas puestas, hay un caso donde la memoria compartida es una mejora directa y sin peros: el conocimiento sobre mi propio stack, el que no pertenece a ningún cliente. Cómo tengo montado el pipeline de publicación con n8n. Qué convenciones sigo en los CLAUDE.md de mis repos. Por qué en Breakdance hago las cosas de una manera concreta y no de la que sugiere la documentación. Qué falla siempre al desplegar. Ese contexto es mío, se repite en todos los proyectos y llevo años reintroduciéndolo a mano en cada conversación nueva.
Ahí el ahorro es real y el riesgo es cero, porque no hay información de terceros que proteger. Y encima es el contexto que más se beneficia de la corrección manual: si Claude ha guardado una versión desactualizada de cómo despliego, la edito una vez y deja de equivocarse en todas las conversaciones futuras. Eso antes no se podía hacer; lo único disponible era repetirse.
Mi plan para los próximos días es exactamente ese: usar la memoria para todo lo que sea sobre mí y mi forma de trabajar, y mantenerla fuera de lo que sea sobre un cliente concreto. Si en algún momento necesito contexto de cliente persistente, seguirá viviendo en el repositorio del proyecto, en su CLAUDE.md, versionado y con un límite claro de dónde empieza y dónde acaba. Un archivo en un repo tiene una propiedad que la memoria automática no tiene: sé con exactitud qué hay dentro porque lo escribí yo.
Lo que aún le falta para que le confíe un proyecto entero
Le pido tres cosas, y ninguna es exótica. La primera, aislamiento por proyecto de verdad: no una carpeta visual, sino la garantía de que lo aprendido en un espacio no se cita en otro. La segunda, exportación: si la memoria se convierte en el sitio donde vive mi contexto de trabajo, necesito poder sacarlo en un formato legible el día que decida cambiar de herramienta. La tercera, trazabilidad: cuando Claude use un dato recordado, quiero saber que lo está usando y de dónde salió. Sin lo tercero, la memoria mejora las respuestas y al mismo tiempo hace más difícil detectar por qué una respuesta es mala.
Ninguna de las tres bloquea usar esto hoy. Las tres decidirán si dentro de un año la memoria de Claude es infraestructura sobre la que se puede construir un negocio o una comodidad que hay que vigilar. Anthropic ha hecho lo más difícil, que era abrir la caja y dejar que el usuario meta la mano. Lo que viene ahora es más aburrido y más importante: convertir ese control puntual en garantías que no dependan de que yo me acuerde de auditar.
Mientras tanto, mi recomendación es tan poco épica como sincera: entra hoy mismo a ver qué ha guardado Claude sobre ti. No por desconfianza, sino porque es la primera vez que se puede. Lo que encuentres ahí te va a decir bastante más sobre cómo trabajas que cualquier análisis que yo pueda escribir.