Durante años, el debate en torno a la optimización de los modelos de lenguaje estuvo centrado en el llamado Prompt Engineering: la disciplina de redactar instrucciones minuciosas, fórmulas lingüísticas precisas o técnicas de ajuste sintáctico para extraer la mejor respuesta posible de una inteligencia artificial. Sin embargo, la rápida evolución hacia agentes autónomos y herramientas de desarrollo avanzadas como Claude Code ha vuelto obsoleta esta aproximación superficial. En el panorama actual, el factor determinante para el éxito operacional de un sistema no es el texto que se le envía en una consulta individual, sino la Ingeniería de Contexto (Context Engineering).
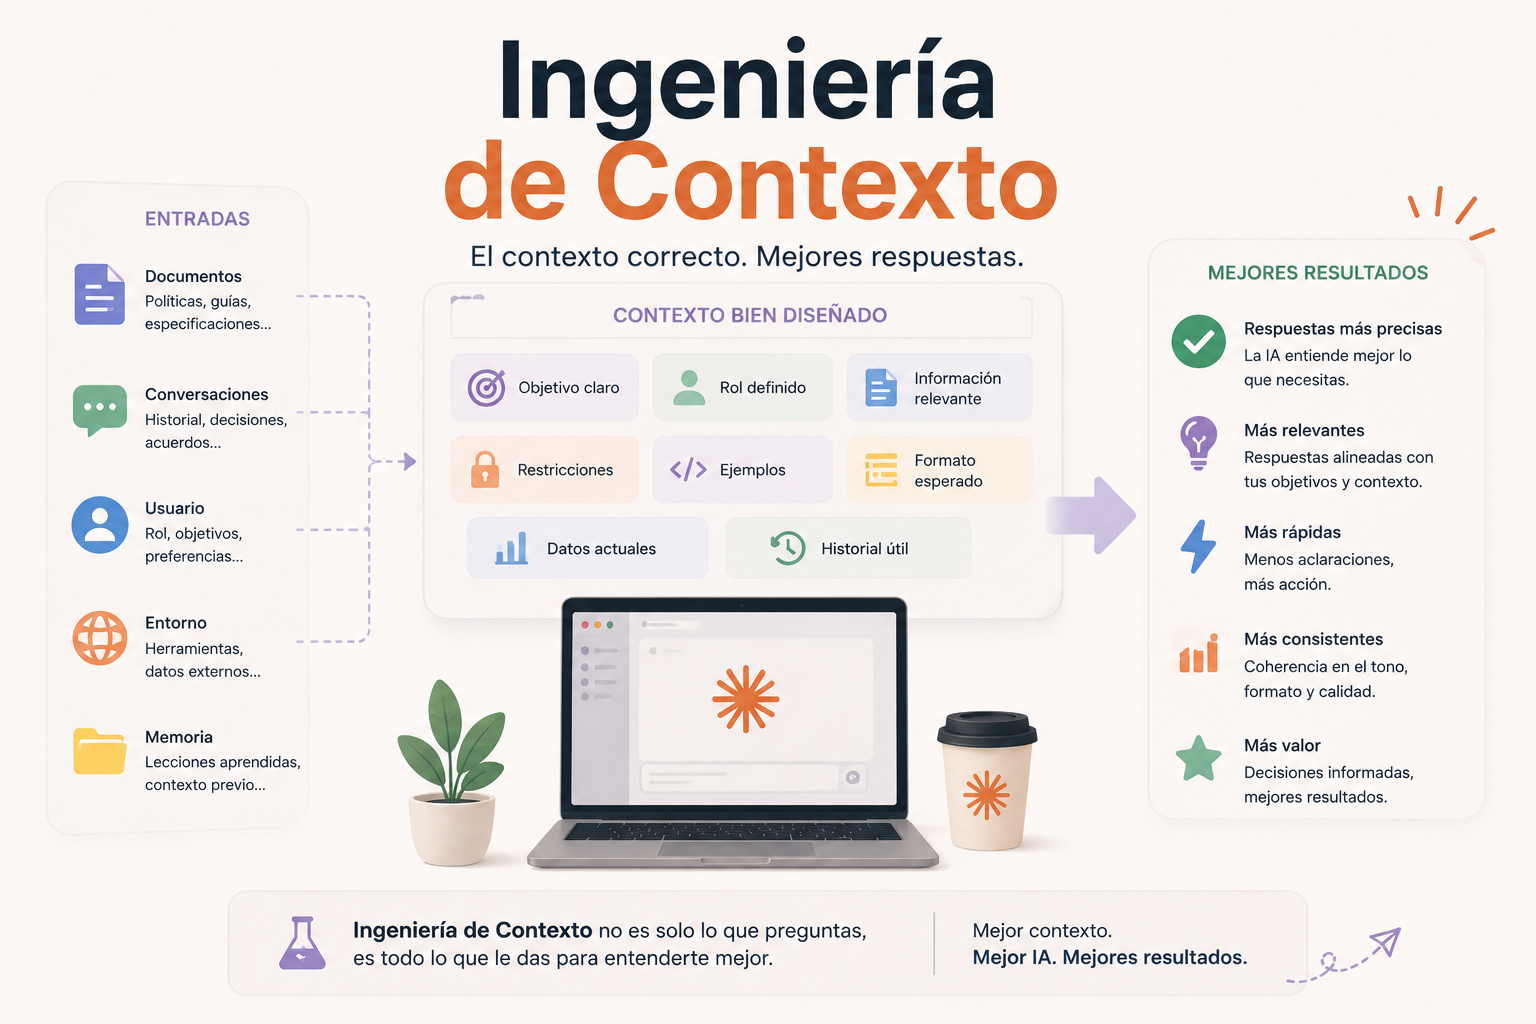
La ingeniería de contexto abarca el diseño integral del entorno de información en el que opera el agente: desde la estructuración de la memoria del repositorio y la delimitación de herramientas disponibles, hasta la gestión dinámica de la ventana de tokens y los archivos de configuración de proyecto. Pasar de intentar «convencer» al modelo a construir la infraestructura donde este actúa representa la diferencia entre una automatización frágil y un sistema de producción robusto.
El fin del Prompt Engineering tradicional: De las frases mágicas a la arquitectura
En las primeras etapas de la IA generativa, añadir pautas como «actúa como un programador experto» o «piensa paso a paso» resultaba eficaz para encauzar respuestas sencillas. No obstante, al delegar tareas complejas y de larga duración a agentes con capacidad de modificar el sistema de archivos o ejecutar comandos de consola, las frases de incentivo revelan rápidamente sus limitaciones. Un agente no ejecuta código de mayor calidad porque se le pida de forma enfática en el prompt, sino porque dispone del contexto adecuado sobre las convenciones del repositorio, la suite de pruebas unitarias y los límites de su alcance.
La ingeniería de contexto desplaza el foco estratégico desde la llamada a la API en tiempo de ejecución hacia el diseño previo del proyecto. Elementos como los archivos de instrucciones de repositorio (por ejemplo, CLAUDE.md), la jerarquía de directorios, la poda selectiva de archivos irrelevantes y el control estricto del estado de la memoria son los verdaderos determinantes del comportamiento del modelo.
La ingeniería de contexto no busca adivinar las palabras correctas para una consulta, sino construir el entorno de información óptimo dentro del cual el agente no pueda cometer errores fatales.
La paradoja del contexto masivo: Por qué más información produce peores resultados
Uno de los errores más comunes al trabajar con ventanas de contexto extendidas —capaces de procesar cientos de miles o millones de tokens— es asumir que suministrar la totalidad de la base de código o de la documentación garantiza una mejor resolución de problemas. En la práctica, ocurre exactamente lo contrario debido a dos fenómenos bien documentados: la degradación de atención en ventanas saturadas (lost-in-the-middle) y la contaminación del contexto.
A medida que la ventana de memoria se llena de logs de ejecución extensos, archivos secundarios irrelevantes o historiales de conversación agotados, la capacidad del modelo para priorizar las instrucciones críticas disminuye. La ingeniería de contexto aplica principios de mínimos privilegios de información: el agente debe recibir exclusivamente el contexto relevante para el fragmento de código o la tarea que debe ejecutar en cada ciclo iterativo.
Componentes fundamentales para diseñar un proyecto optimizado para agentes
Para implementar con éxito la ingeniería de contexto en proyectos de desarrollo o automatizaciones empresariales, es necesario vertebrar la infraestructura en torno a cuatro pilares fundamentales:
- Archivos de gobierno de repositorio (
CLAUDE.md): Ubicado en la raíz del proyecto, este archivo actúa como la fuente de verdad del agente. Debe incluir comandos de compilación y prueba, convenciones de estilo de código, arquitectura modular del proyecto y restricciones explícitas de lo que el agente no debe modificar. - Poda dinámica del árbol de archivos (
.ignore/ filtros): Configurar de forma rigurosa los archivos ignorados para evitar que el agente indexe o lea dependencias masivas (comonode_modules, directorios de caché o entornos virtuales) que consumen presupuesto de tokens sin aportar valor semántico. - Modularización de prompts del sistema por tarea: En lugar de utilizar un prompt genérico omnisciente, la capa de orquestación debe inyectar fragmentos de contexto especializados en función de la fase actual del flujo (p. ej., un contexto para refactorización, otro para generación de pruebas y otro para revisión de seguridad).
- Persistencia de estado fuera del hilo principal: Almacenar el historial de cambios y decisiones críticas en bases de datos externas o registros intermedios (como Redis o archivos de estado JSON), permitiendo reiniciar sesiones de agente con un contexto fresco sin perder el progreso histórico.
CLAUDE.md específico en la raíz del tema personalizado. Defina exactamente las funciones permitidas de la API de WordPress, las reglas de formateo de código PHP y el comando exacto para ejecutar las pruebas automáticas antes de generar cualquier commit.
De la improvisación al diseño de software impulsado por contexto
El paso del Prompt Engineering a la Ingeniería de Contexto simboliza la maduración de la inteligencia artificial como disciplina de ingeniería de software. Los agentes autónomos ya no deben entenderse como oráculos a los que se interroga con maestría retórica, sino como motores de ejecución altamente eficientes que dependen directamente de la calidad de la arquitectura de datos e instrucciones con la que se les rodee.
Invertir tiempo en estructurar adecuadamente los repositorios, delimitar el alcance de las herramientas y gestionar con precisión quirúrgica el flujo de tokens es la única estrategia sostenible para desplegar sistemas de IA autónomos que aporten valor continuo sin requerir constante supervisión manual ni poner en riesgo los entornos de producción.