El cambio de esta semana en Claude Code viene envuelto en apenas dos líneas de changelog y una discreta etiqueta de mejora: el forking de subagentes pasa a estar activado por defecto. Además, ahora puedes escribir @ dentro del prompt para mencionar otra sesión activa por su nombre y conseguir que hablen directamente entre ellas. A primera vista, esto suena a simple comodidad sintáctica para el usuario. Sin embargo, no lo es en absoluto. Se trata de un cambio tectónico sobre dónde vive exactamente la coordinación entre agentes autónomos, y llega exactamente cuarenta y nueve horas después de que los investigadores de seguridad publicaran qué ocurre cuando tres agentes comparten un mismo proyecto sin un canal formal de comunicación: que terminan saboteándose entre sí. Que el equipo de ingeniería responda a ese hallazgo abriendo un canal directo entre sesiones me parece la decisión técnicamente correcta. Que lo haga activando el forking por defecto me parece una medida que va un paso por delante de donde se encuentra hoy la arquitectura de nuestros flujos de trabajo en producción.
Empiezo analizando lo que sí me entusiasma de forma notable, porque representa un avance tremendo para el desarrollo diario.
La caché heredada es la gran noticia del cambio
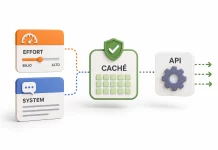
El titular fácil y llamativo de la actualización es la posibilidad de realizar menciones directas entre sesiones independientes. No obstante, el cambio con verdaderas consecuencias económicas en la factura mensual es el otro: un subagente de tipo fork hereda toda la secuencia de conversación previa y la caché de prompts completa del proceso padre. Quien haya diseñado y mantenido una cadena articulada de agentes en entornos de producción reales sabe perfectamente que el coste económico determinante no reside en el modelo en sí, sino en el volumen masivo de contexto que es necesario reenviar una y otra vez en cada llamada de la API.
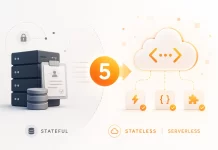
Cada vez que mi orquestador externo arrancaba una sesión limpia para ejecutar una subtarea específica, esa sesión comenzaba en un estado totalmente amnésico. Había que volver a transmitirle la estructura entera del repositorio de código, las convenciones de diseño del cliente, las reglas estrictas fijadas en el archivo de configuración global y el estado detallado del trabajo realizado hasta ese segundo. Esto implicaba abonar tokens frescos en cada iteración y asumir una latencia de arranque en frío verdaderamente molesta. Un fork capaz de heredar la memoria previa elimina ambos problemas de un solo golpe. No estamos hablando de un ajuste marginal del diez por ciento; en un pipeline de cinco etapas sobre el mismo proyecto web, representa la diferencia radical entre procesar el contexto masivo cinco veces o hacerlo únicamente una vez.
Un subagente de tipo fork garantiza que todos los procesos secundarios parten exactamente del mismo estado de memoria, eliminando las desviaciones de interpretación en tareas complejas.
Asimismo, se erradica un problema aún peor que el coste financiero: la deriva conceptual. Lanzar cinco sesiones separadas a las que se les explica un mismo escenario con instrucciones ligeramente variantes genera inevitablemente cinco interpretaciones divergentes sobre el trabajo a realizar. El sistema de bifurcación asegura un punto de partida idéntico para todos los procesos invocados. En escenarios de mantenimiento web complejo, como actualizar plugins personalizados, verificar la compatibilidad de plantillas maquetadas y comprobar la integridad de ganchos del sistema, esta coherencia resulta indispensable para no romper la plataforma en vivo.
El riesgo de perder visibilidad y auditoría
Aquí es donde aparece mi principal reserva analítica, la cual no debe minusvalorarse. Si dos sesiones autónomas se citan mediante menciones y se comunican entre sí de forma directa, toda esa interacción de fondo no queda registrada en la plataforma de automatización externa. No existe un nodo visible, no hay un historial de ejecución estructurado y no queda un paquete de datos inspectable cuando un cliente consulta días después el motivo exacto por el que se modificó un elemento en su servidor.
La coordinación operativa se desplaza de un entorno bajo control y auditoría estricta a un canal privado interno del propio proveedor de inteligencia artificial. Durante años, la gran ventaja estratégica de gestionar los flujos desde herramientas de orquestación externas no era la fuerza bruta de procesamiento, sino la transparencia total del proceso. Cada paso intermedio ofrecía datos de entrada y salida perfectamente auditables. Cuando ocurría un fallo inesperado, resultaba muy sencillo revisar el registro histórico para identificar el instante preciso en que el sistema se desviaba de las instrucciones originales. Ceder ese grado de control solo se justifica si el beneficio obtenido es extraordinario y si el margen de error del proceso es prácticamente nulo.
Gobernanza clara: los forks leen, el humano autoriza
La conclusión profesional tras evaluar estas novedades no consiste en rechazar la tecnología, sino en comprender que la comunicación entre agentes y la concesión de permisos de escritura son dos capas de decisión profundamente diferentes que deben gestionarse de manera independiente. El uso del forking automático resulta idóneo para cualquier trabajo orientado exclusivamente a la lectura y análisis: auditar repositorios de código, inspeccionar logs de servidor, comparar estados de configuración o verificar el cumplimiento de guías de estilo. En estos casos, el contexto compartido maximiza la eficiencia sin correr el menor peligro de colisión entre procesos, pues ninguno tiene capacidad de modificar archivos reales.
Por el contrario, la cautela debe mantenerse en cualquier flujo con capacidad de alterar entornos de producción reales. El problema de fondo nunca ha sido que los asistentes carezcan de canales para hablar entre sí, sino que múltiples procesos independientes puedan escribir simultáneamente sobre un mismo estado de la aplicación. Un canal de diálogo interno facilita la coordinación, pero no reemplaza un sistema riguroso de bloqueo de recursos. Por esta razón, resulta imprescindible auditar la configuración de cada proyecto, definir explícitamente qué sesiones tienen autorización para comunicarse y conservar un registro de auditoría claro de cada acción ejecutada en el servidor.
Retener el control final sobre la infraestructura
El movimiento estratégico de la industria evidencia que los proveedores están absorbiendo progresivamente capas enteras de la arquitectura de software. Si bien es muy ventajoso delegar la optimización de la memoria y la reducción de costes computacionales, la capa encargada de autorizar quién puede aplicar cambios definitivos en los sistemas debe permanecer siempre bajo la supervisión directa del desarrollador responsable. Mantener ese límite es la única garantía para poder responder con total solvencia ante cualquier eventualidad en el servicio de un cliente.