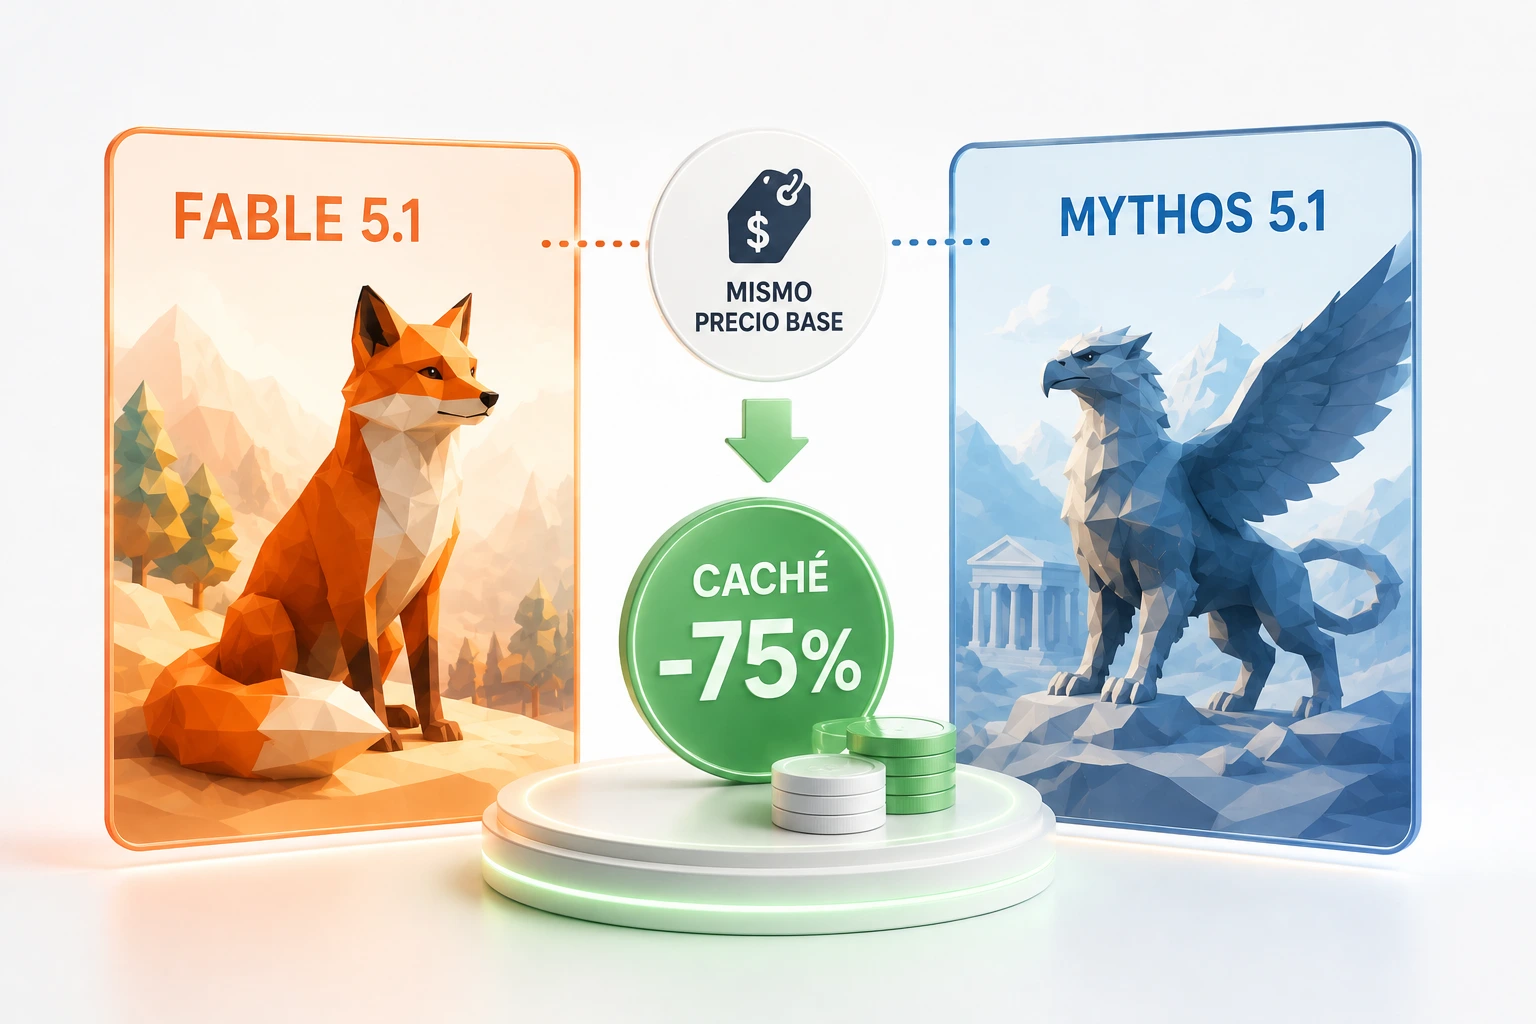
Anthropic ha lanzado Claude Fable 5.1 y Claude Mythos 5.1, y el titular no está en los benchmarks —que también mejoran— sino en una línea de la tabla de precios: las lecturas de caché bajan de 1 a 0,25 dólares por millón de tokens, un 75% menos. El precio base no se mueve, así que el ahorro real que verás depende por completo de cuánta caché reutilices: la compañía habla de en torno a un 25% menos para cargas típicas y hasta un 45% en trabajo muy agéntico.
Dos nombres para el mismo modelo, con distinta correa
Lo primero que hay que entender es que Fable 5.1 y Mythos 5.1 son el mismo modelo: lo que cambia es el nivel de salvaguardas. Fable 5.1 sale en disponibilidad general y está desde hoy en la API con el identificador claude-fable-5-1, además de Amazon Bedrock, Claude Platform on AWS, Google Cloud y Microsoft Foundry.
Mythos 5.1, en cambio, queda restringido a programas de acceso verificado: ciberdefensores y científicos de ciencias de la vida que pasen por un proceso de validación. Es la misma estrategia que ya se vio con la generación anterior —una versión con menos restricciones para quien demuestre a qué se dedica— y explica por qué verás las dos referencias juntas en todos los titulares aunque solo una te afecte.
Fable 5.1 llega además con ventana de contexto de un millón de tokens por defecto, un máximo de 128.000 tokens de salida y pensamiento adaptativo siempre activo. No hay que activar nada: son los valores de partida del modelo.
El precio base no baja; lo que baja es reutilizar contexto
Los números concretos: 10 dólares por millón de tokens de entrada y 50 por millón de salida, exactamente lo mismo que Fable 5. Lo que cambia es la lectura de caché, que pasa a costar 0,25 dólares por millón, es decir 0,025 veces el precio de entrada base. Antes eran 1 dólar.
Traducido a la práctica: este modelo premia el trabajo que repite contexto y no cambia nada para el que hace llamadas sueltas. Si tu patrón es una petición aislada con un prompt corto, tu factura será idéntica a la de la semana pasada. Si tu patrón es una sesión larga que arrastra el mismo repositorio, el mismo esquema de base de datos o las mismas instrucciones de estilo en cada turno, ahí es donde aparece el 45%.
El descuento no lo fija Anthropic: lo fija tu ratio de aciertos de caché.
Y ese matiz es importante porque los dos porcentajes del anuncio son medias de otra gente. El tuyo sale de una división que puedes hacer tú: cuántos de tus tokens de entrada son lecturas de caché frente a entrada nueva. Cuanto más alto sea ese ratio, más se acerca tu ahorro al 45%; cuanto más bajo, más se acerca a cero.
💡 Mide antes de anunciar el ahorro
En Claude Code, ejecuta /cost en una sesión de trabajo real y mira la línea de caché de prompts: ratio de aciertos, fallos y tokens recacheados. Ese número es el que decide tu descuento. Si trabajas contra la API desde n8n, el desglose equivalente está en el objeto usage de cada respuesta, en los campos de lectura y escritura de caché.
Los benchmarks: buenos, y con una lectura menos obvia
Las cifras que da Anthropic son sólidas. En Terminal-Bench 4.0, que mide trabajo agéntico en terminal, marca 55,8% frente al 42,0% de Fable 5 y el 52,3% de Opus 5. En Terminal-Bench-Science 0.1 sube a 52,6% desde el 24,7% anterior, más del doble. Y en CursorBench 3.2.0 se queda en 73,4%.
La lectura menos obvia está en el salto de la variante científica: duplicar una puntuación no es una mejora incremental de un modelo que ya sabía hacer algo, es un modelo que antes fallaba en la mayoría de esas tareas y ahora las resuelve la mitad de las veces. Sigue siendo un aprobado raspado en términos absolutos, y conviene decirlo: el 55,8% de Terminal-Bench significa que casi una de cada dos tareas agénticas no sale.
Como referencia útil para decidir, la comparación relevante para la mayoría no es con Fable 5, sino con Opus 5: tres puntos y medio de diferencia en Terminal-Bench a favor del nuevo. Suficiente para justificar la prueba, no tanto como para rehacer todo un flujo que funcione bien.
En el mismo movimiento, Anthropic ha reajustado las salvaguardas del modelo para reducir los rechazos que molestaban al trabajo legítimo, sobre todo en ciberseguridad y en biología. Es un cambio con entidad propia y lo tratamos por separado.
Qué cambia si trabajas con Claude Code y n8n
Tres consecuencias prácticas. La primera: en Claude Code, Fable 5.1 arranca con nivel de esfuerzo High por defecto. Es un detalle de configuración que conviene tener presente antes de mirar la factura del primer día, porque más esfuerzo significa más tokens de razonamiento.
La segunda: si tus workflows de n8n reenvían el mismo bloque de contexto en cada nodo —plantillas, instrucciones de marca, esquema de contenido—, ese es exactamente el patrón que abarata este modelo. Merece la pena revisar si ese bloque está entrando como contexto cacheado o como entrada nueva en cada llamada, porque de eso depende todo el ahorro.
Y la tercera, la más aburrida y la que más disgustos evita: cambiar de modelo no es cambiar una cadena de texto. Un modelo nuevo llega con parámetros por defecto distintos y con cambios en la API que pueden romper llamadas que hoy funcionan. Prueba en un flujo secundario antes de tocar el que publica en el WordPress de un cliente, y compara el coste real de la misma tarea antes y después, no el precio de lista.