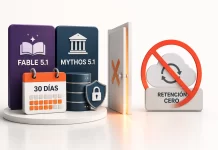
Entre las mejoras de rendimiento del lanzamiento de Fable 5.1 hay un cambio que va a notarse más en el día a día que cualquier benchmark: las salvaguardas del modelo se han reajustado para molestar menos al trabajo legítimo. Anthropic cifra la mejora en alrededor de un 60% menos de falsos positivos en ciberseguridad para quienes usan Claude Code, y traza una línea de política nueva: el modelo ya puede usarse para descubrir vulnerabilidades de software, pero no para desarrollar exploits a partir de ellas.
El falso positivo era el motivo número uno de abandono
Quien haya intentado usar un modelo para revisar seguridad conoce la escena. Le pasas una función que valida entradas de un formulario, le preguntas si hay algún vector de inyección, y en lugar de una respuesta recibes una negativa educada sobre por qué no puede ayudarte con actividades potencialmente dañinas. El código es tuyo, el sitio es de tu cliente y el objetivo es taparlo, pero el clasificador ha visto tres palabras clave juntas y ha decidido por su cuenta.
El coste de ese comportamiento no es la negativa en sí: es que rompe el trabajo a mitad de sesión. Cuando eso pasa dos veces seguidas, el resultado práctico no es que el usuario reformule el prompt con más educación; es que cierra la herramienta y hace la revisión a mano, o la hace con otra que no le discuta.
Por eso un 60% menos de falsos positivos es una cifra con más impacto real que un par de puntos en un benchmark. Un modelo que se niega a mirar código de seguridad legítimo no es un modelo prudente: es un modelo que no sirve para ese trabajo.
Una negativa injustificada no hace que el usuario reformule el prompt: hace que cierre la herramienta.
La línea nueva: encontrar sí, armar no
El cambio de política es el que merece más atención, porque es explícito y define dos territorios. Descubrir vulnerabilidades entra dentro de lo permitido: analizar código en busca de fallos, señalar dónde está el problema y explicar por qué es explotable en teoría. Desarrollar el exploit no: construir el artefacto funcional que convierte ese fallo en una intrusión sigue fuera.
Es una distinción que la comunidad de seguridad lleva décadas discutiendo y que aquí se aplica como criterio de producto. Tiene sentido práctico: el trabajo defensivo se pasa el 90% del tiempo en la primera mitad —encontrar, entender, priorizar, corregir— y casi nunca necesita un exploit armado para hacer su trabajo. Quien audita el plugin de un cliente quiere saber que la consulta no está parametrizada, no necesita una carga útil lista para lanzarla.
La línea no es perfecta y conviene no venderla como tal: en seguridad, la frontera entre demostrar que un fallo es real y explotarlo es a veces cuestión de un paso. Pero como criterio operativo desbloquea la mayoría del trabajo honesto sin regalar la parte ofensiva, que es probablemente lo mejor que se puede pedir a una regla automática.
Biología y medicina: un 85% menos de bloqueos
El otro ajuste va en la misma dirección, en un dominio distinto: el marcado de contenido benigno en consultas de biología y medicina baja un 85%. Es el mismo problema con otro disfraz —terminología que dispara alarmas en contextos completamente legítimos— y afecta a investigadores, personal sanitario y a cualquiera que trabaje con textos técnicos de esas áreas.
El patrón que dibujan las dos cifras es interesante por sí mismo. Durante dos años, la seguridad de estos modelos se ha medido sobre todo por lo que bloqueaban; que ahora se anuncie como logro cuánto han dejado de bloquear indica que el listón se ha movido: un modelo excesivamente restrictivo empieza a contarse como un modelo defectuoso, no como uno prudente.
Y para lo que no cabe ahí, está Mythos
El complemento de esta política es el reparto en dos modelos. Mythos 5.1 es el mismo modelo con menos restricciones, y está reservado a programas de acceso verificado: ciberdefensores y científicos de ciencias de la vida que pasen un proceso de validación. Para el ámbito biomédico hay un programa específico con inscripción abierta próximamente a investigadores.
La arquitectura de fondo es clara y bastante razonable: en lugar de un único ajuste intermedio que descontenta a todos, dos niveles y una puerta con verificación en medio. El precio es que esa puerta existe, con su proceso, sus requisitos y su decisión ajena. Para el trabajo de un freelance, la versión general es la que hay, y la buena noticia es que acaba de volverse notablemente más utilizable.
💡 Qué puedes pedirle hoy que antes se atascaba
Revisar un plugin o un tema de WordPress buscando inyección SQL, XSS o validación ausente; auditar cómo tu propio código maneja credenciales y sesiones; repasar la configuración de un servidor en busca de exposiciones; entender por qué un CVE publicado afecta a una dependencia que usas. Todo eso cae del lado permitido. Lo que sigue fuera es pedirle el exploit funcional, y para el trabajo defensivo eso rara vez hace falta.
Un apunte práctico antes de dar por hecho el cambio: estas cifras son medias sobre las evaluaciones internas de Anthropic, no una garantía sobre tu caso. Si tu flujo de trabajo chocaba sistemáticamente con negativas, la forma de saber si ha mejorado es repetir el mismo caso que fallaba y comprobarlo, no fiarse del porcentaje.
Y una consecuencia que conviene tener presente si vendes servicios: este ajuste convierte la revisión de seguridad asistida en algo que ya se puede ofrecer con cara seria. Hasta ahora, incluirla en una propuesta tenía el riesgo de que la herramienta se plantara a mitad del encargo. Sigue haciendo falta criterio propio para validar lo que el modelo señala —los falsos positivos que quedan ahora son técnicos, no de política—, pero el obstáculo que hacía inviable el flujo entero acaba de bajar bastante.